
Qué ha cambiado en el índice
Según Artificial Analysis, se trata de la mayor actualización desde principios de año. El cambio principal es que aproximadamente el 60 % del índice se basa ahora en conjuntos de pruebas privados o respuestas reservadas, con el objetivo de impedir que los modelos se entrenen simplemente con preguntas de evaluación conocidas. El índice se compone de cuatro categorías con la misma ponderación:
- Trabajo del conocimiento: tareas similares a las de una oficina real, como editar documentos y gestionar automatizaciones.
- Programación: la novedad es FrontierCode 2.0, una prueba privada de la empresa de IA Cognition. Una solución solo cuenta si un responsable de mantenimiento realmente la aceptaría para integrarla en el proyecto.
- Ciencia: la novedad es Terminal-Bench-Science, con 70 tareas de investigación que un modelo debe completar de forma autónoma, además de una prueba de física especialmente difícil.
- Conocimientos generales: una versión nueva y más difícil de Humanity’s Last Exam y una prueba que penaliza las alucinaciones.
Entre las pruebas eliminadas se encuentran la conocida evaluación de programación SciCode y la prueba de trabajo del conocimiento GDPval-AA.
La nueva clasificación
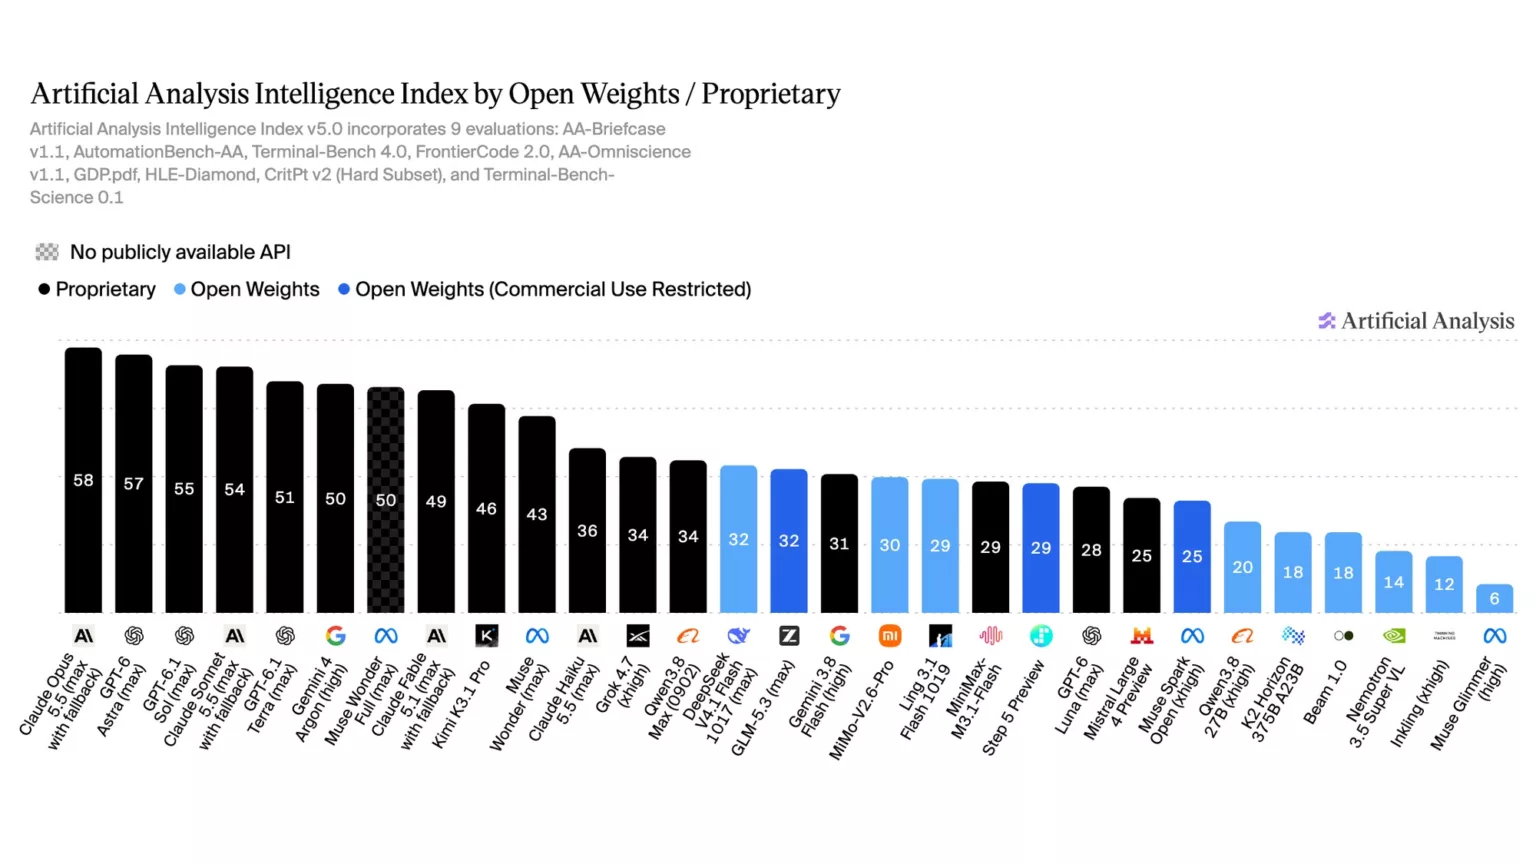
Hay pocos cambios en los primeros puestos, pero muchos más por debajo. Si se comparan las puntuaciones con las de la versión anterior, que Trending Topics publicó recientemente, el panorama es el siguiente:
- Claude Opus 5.5 (Anthropic): se mantiene en cabeza con 58 puntos.
- GPT-6 Astra (OpenAI): sube de 53 a 57 puntos y ocupa el segundo puesto.
- GPT-6.1 Sol (OpenAI): obtiene 55 puntos con aproximadamente una octava parte del coste de Opus.
- Claude Sonnet 5.5 (Anthropic): baja ligeramente, de 56 a 54 puntos.
- Gemini 4 Argon (Google): cae de 53 a 50 puntos.
- Muse Wonder Full (Meta): retrocede considerablemente, de 56 a 50 puntos.
Ningún modelo gana las nueve pruebas individuales. Opus 5.5 lidera tres de ellas.
Los modelos abiertos reciben un duro golpe
Los modelos de pesos abiertos, cuyos pesos están disponibles libremente para que cualquiera pueda ejecutarlos, son los más afectados:
- Kimi K3.1 Pro (Moonshot AI): baja de 55 a 46 puntos. Sigue siendo el mejor modelo abierto, aunque Moonshot todavía no ha publicado sus pesos.
- DeepSeek V4.1 Flash: se desploma de 45 a 32 puntos.
- MiMo-V2.6-Pro (Xiaomi): pierde 16 puntos y termina con 30.
- Muse Spark Open (Meta): el mejor modelo abierto de Estados Unidos cae de 39 a 25 puntos.
El mejor modelo cuyos pesos ya están disponibles se encuentra ahora 26 puntos por detrás del líder. Incluso el pequeño y económico Claude Haiku 5.5 de Anthropic, con 36 puntos, supera a todos los modelos abiertos cuyos pesos se han publicado. La gran esperanza europea, Mistral, tampoco obtiene mejores resultados: su modelo de prueba aún no abierto, Mistral Large 4 Preview, alcanza 25 puntos.
Las mayores diferencias aparecen en las nuevas pruebas, que son más difíciles. En la versión revisada de Humanity’s Last Exam, Kimi obtiene un 37 % y Opus un 68 %. En las tareas científicas para agentes, Kimi alcanza el 34 % y GPT-6 Astra el 63 %, mientras que la mayoría de los modelos abiertos se mantienen por debajo del 10 %.
Evaluar los límites de los modelos resulta más caro
Las nuevas pruebas exigen mucho más a los modelos. En cada tarea, los modelos generan una mediana de aproximadamente 59.000 tokens de salida, dos tercios más que antes. Esto se refleja en los costes: una ejecución de Claude Opus 5.5 con su configuración más alta cuesta unos 10 dólares (aproximadamente 9 euros) por tarea, según Artificial Analysis, frente a unos 1,27 dólares (aproximadamente 1,13 euros) para GPT-6.1 Sol. La capacidad de cálculo que se permite utilizar a un modelo marca una enorme diferencia: con su configuración más baja, Opus 5.5 obtiene solo 35 puntos.
Una clasificación solo es tan buena como sus pruebas
En el caso de los modelos abiertos, el resultado es menos concluyente de lo que parece a primera vista. Kimi K3.1 Pro, por ejemplo, lidera toda la clasificación en la prueba de agentes Terminal-Bench 4.0, por delante de todos los modelos propietarios. La clasificación también depende en gran medida de las pruebas que elige una empresa de evaluación comparativa y del peso que les asigna: en la versión anterior, Kimi K3.1 Pro todavía ocupaba el cuarto puesto, a solo tres puntos del líder. Además, como la mayoría de los datos de las pruebas son ahora secretos, los resultados ya no pueden verificarse de forma independiente desde el exterior. Por el contrario, Artificial Analysis recurre precisamente a datos de prueba secretos para impedir que los modelos puedan entrenarse con preguntas conocidas.
Roberto Méndez
Corresponsal Económico y Tecnología
Especialista en economía política europea, soberanía tecnológica industrial y análisis de fondos soberanos en la zona euro. Colaborador habitual en medios internacionales.