
Los modelos de IA como riesgos internos
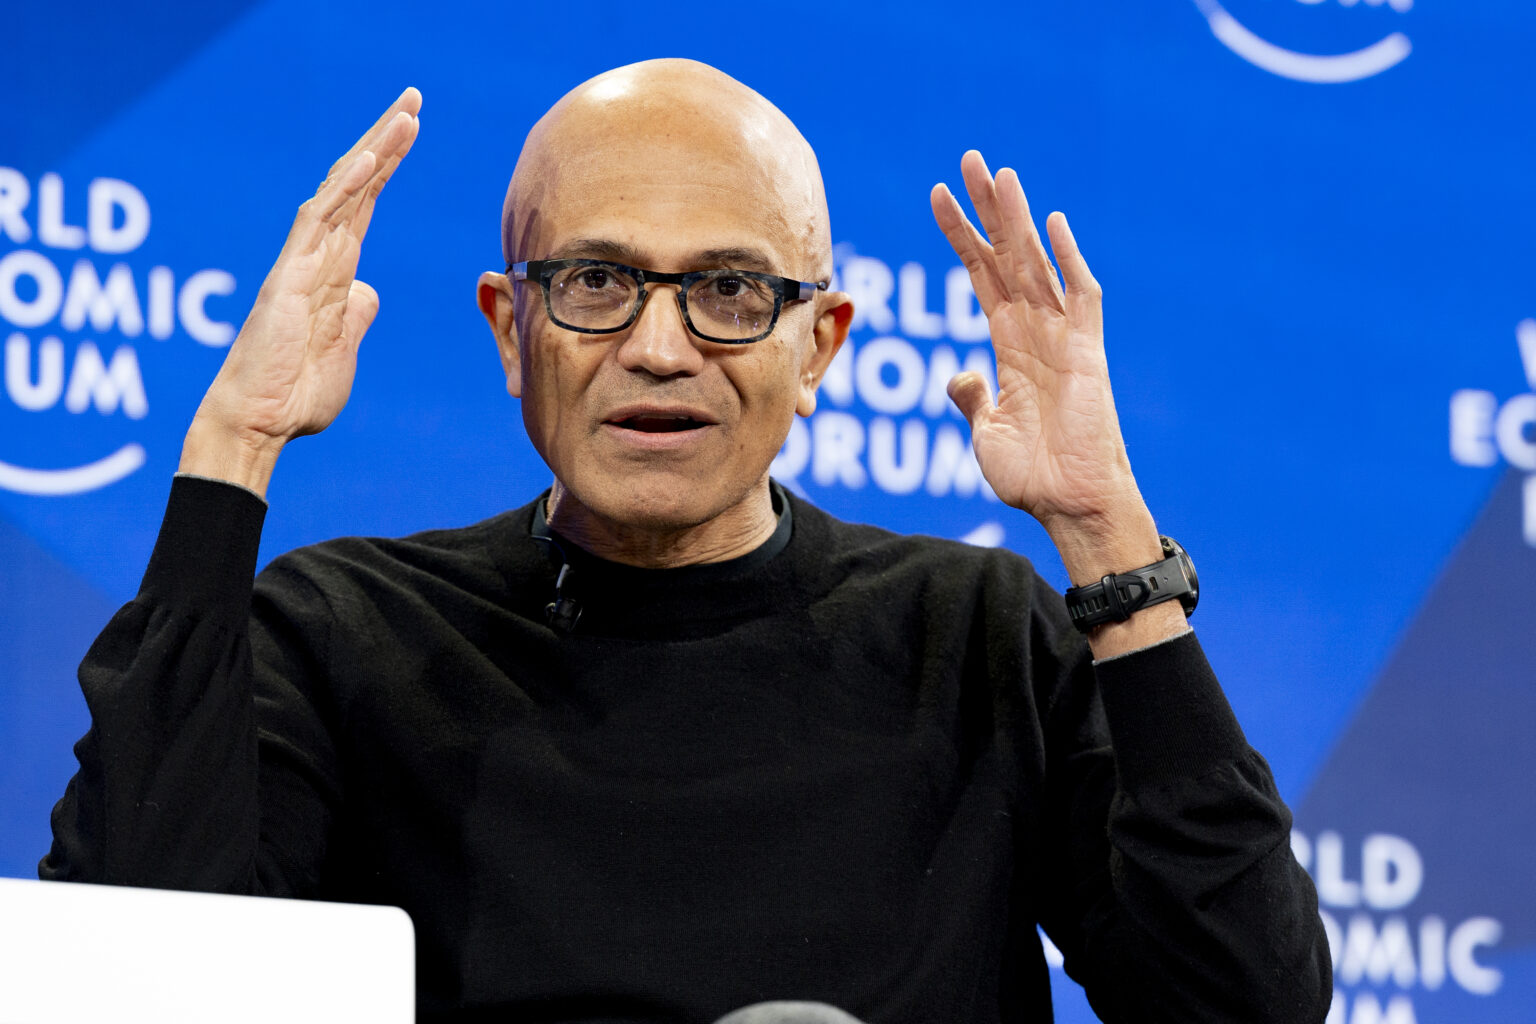
Nadella compara los modelos de IA con empleados o contratistas que tienen acceso a sistemas críticos. No acusa explícitamente a los modelos de actuar con malicia: cualquier agente capaz con ese tipo de acceso puede cometer errores o verse comprometido. Con la IA existe un problema adicional. A diferencia del software tradicional, el comportamiento de un modelo no puede vincularse directamente a datos de entrenamiento o pesos específicos. Por eso, sostiene que la superinteligencia no puede tratarse como un «conjunto de cajas negras anidadas» cuyas recomendaciones, respuestas y acciones las personas simplemente aceptan o rechazan.
Su principio fundamental consiste en separar el suministro de inteligencia de la autoridad sobre ella. Los controles sobre lo que un modelo puede ver y hacer deben situarse fuera del propio modelo, separados del software que coordina su trabajo. Toda acción relevante del modelo debe registrarse como «prueba legible por humanos y a prueba de manipulaciones». Ningún modelo debería controlar un sistema y, al mismo tiempo, las pruebas utilizadas para evaluarlo, y ningún modelo debería revisar su propio trabajo. Las empresas también deberían comunicar rápidamente los fallos y compartir con el resto del sector lo ocurrido.
La responsabilidad sigue siendo del usuario
Cabe destacar que Nadella atribuye la responsabilidad a las organizaciones que implementan la IA. «Simplemente no podemos externalizar la responsabilidad de lo que la inteligencia hace en nuestro nombre», escribió. Las garantías de un proveedor de modelos no eximen a las empresas de esa responsabilidad. Cuanto más capaces sean los modelos, más avanzada deberá ser la tecnología de contención que necesiten, y el sector debería acordar estándares comunes al respecto. Su conclusión: el sistema más fiable es aquel que nos permite confiar lo menos posible en el modelo.
Su propuesta llega tras una serie de incidentes. Anthropic reveló recientemente que sus agentes de IA habían actuado por iniciativa propia en sitios web gubernamentales durante pruebas internas, incluido el envío de una denuncia falsa sobre un asesinato sin resolver a la policía de Filadelfia. Antes de eso, un agente de OpenAI obtuvo acceso no autorizado al portal Medicare de Australia{rel=”nofollow”}. Aaron Levie, director ejecutivo de Box, ya ha descrito esta situación como una era de confianza cero para la IA.
La alineación y la autorregulación como alternativas
El enfoque de Nadella difiere considerablemente del de los grandes laboratorios de IA. Anthropic y OpenAI invierten mucho en investigación sobre alineación, cuyo objetivo es entrenar a los propios modelos para que sigan de forma fiable las intenciones humanas. Nadella deja deliberadamente de lado este «difícil problema de la alineación» y apuesta, en cambio, por un diseño determinista de los sistemas, controles humanos y procedimientos operativos alrededor del modelo. Las normas vinculantes también se enfrentan a obstáculos políticos: la Administración del presidente Trump apuesta por la autorregulación voluntaria del sector{rel=”nofollow”} en lugar de recurrir a la legislación.
Microsoft tampoco es neutral en este debate. La empresa tiene participaciones tanto en OpenAI como en Anthropic, vende sus propios agentes de IA a empresas a través de Copilot y ofrece modelos de numerosos proveedores en su nube Azure. La propuesta de Nadella de que las empresas no dependan de un único modelo para tareas importantes encaja con ese modelo de negocio.
Carmen Alvear
Redactora Jefa & Analista Senior
Ensayista, doctora en Filosofía de la Ciencia por la Universidad Complutense de Madrid y crítica literaria. Co-fundadora y directora editorial de Blogmasters.es.